Trong bài này (12 mục)
- RAG hoạt động như thế nào?
- Vì sao RAG ra đời? Vấn đề nó giải quyết
- Kiến trúc kỹ thuật của một hệ thống RAG {#kien-truc-ky-thuat}
- Lợi ích thực tế của RAG
- Hạn chế và thách thức khi triển khai RAG
- RAG khác gì Fine-tuning?
- Ứng dụng thực tế của RAG
- Các bước xây dựng hệ thống RAG cơ bản
- Xu Hướng RAG Đáng Chú Ý (2026)
- Câu hỏi thường gặp (FAQ)
- Nguồn tham khảo
- Đọc tiếp trong chủ đề: AI cho doanh nghiệp
RAG (Retrieval-Augmented Generation) là kỹ thuật kết hợp giữa mô hình ngôn ngữ lớn (LLM) với một hệ thống truy xuất dữ liệu bên ngoài, giúp AI trả lời dựa trên thông tin thực tế, cập nhật thay vì chỉ dựa vào kiến thức đã học sẵn. Nói đơn giản: thay vì để mô hình "đoán" câu trả lời từ trí nhớ, RAG cho phép mô hình "tra cứu" tài liệu liên quan trước khi trả lời — giống như một người vừa có kiến thức nền, vừa được mở sách tham khảo khi làm bài. Bài viết này tổng hợp toàn bộ kiến thức về RAG: cách hoạt động, kiến trúc kỹ thuật, lợi ích, hạn chế thực tế, và các ứng dụng phổ biến — dựa trên tài liệu nghiên cứu gốc và trải nghiệm triển khai thực tế.
RAG hoạt động như thế nào?
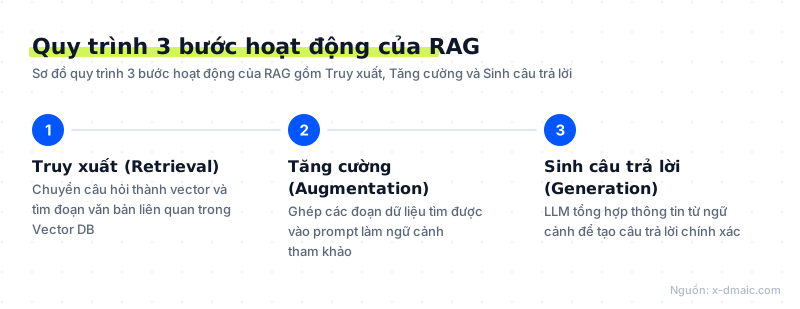
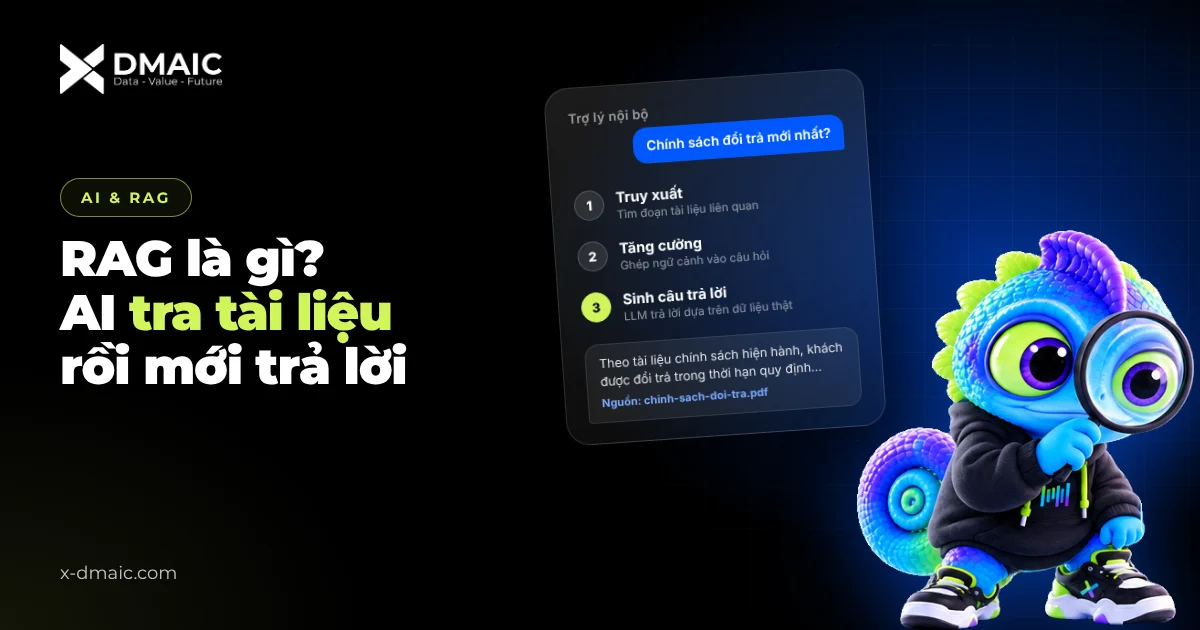
Một hệ thống RAG hoạt động qua 3 bước chính:
- Truy xuất (Retrieval): Khi người dùng đặt câu hỏi, hệ thống chuyển câu hỏi thành vector số (embedding) rồi tìm kiếm trong cơ sở dữ liệu vector (vector database) những đoạn văn bản có nội dung gần nghĩa nhất.
- Tăng cường (Augmentation): Các đoạn văn bản tìm được sẽ được chèn vào prompt, đóng vai trò là "ngữ cảnh tham khảo" gửi kèm câu hỏi gốc tới LLM.
- Sinh câu trả lời (Generation): LLM đọc cả câu hỏi lẫn ngữ cảnh được cung cấp, sau đó tổng hợp thành câu trả lời tự nhiên, có căn cứ trên dữ liệu thật thay vì chỉ dựa vào tham số đã học trong quá trình huấn luyện.
Ví dụ thực tế: khi triển khai một chatbot hỗ trợ nội bộ cho một doanh nghiệp có khoảng 3.000 trang tài liệu quy trình, việc dùng RAG giúp chatbot trả lời chính xác các câu hỏi về chính sách nội bộ mới cập nhật trong tuần — điều mà một LLM thuần (không có RAG) không thể làm được vì dữ liệu đó không nằm trong tập huấn luyện gốc của mô hình.
Vì sao RAG ra đời? Vấn đề nó giải quyết
Các mô hình ngôn ngữ lớn có ba giới hạn cố hữu mà RAG được thiết kế để khắc phục:
| Vấn đề của LLM thuần | Cách RAG giải quyết |
|---|---|
| Kiến thức đóng băng tại thời điểm huấn luyện, không biết thông tin mới | Truy xuất dữ liệu mới nhất từ nguồn ngoài theo thời gian thực |
| Ảo giác (hallucination) — bịa thông tin nghe có vẻ hợp lý | Câu trả lời có căn cứ (grounded) trên tài liệu truy xuất được, giảm tỷ lệ bịa đặt |
| Không có kiến thức riêng tư/nội bộ của tổ chức | Kết nối với dữ liệu nội bộ (tài liệu công ty, database, wiki nội bộ...) mà không cần huấn luyện lại mô hình |
Khái niệm RAG được giới thiệu chính thức trong nghiên cứu "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks" của nhóm nghiên cứu Meta AI (Facebook AI Research) năm 2020, mở đường cho hướng tiếp cận kết hợp giữa truy xuất thông tin (information retrieval) và mô hình sinh văn bản (generative model).
Kiến trúc kỹ thuật của một hệ thống RAG {#kien-truc-ky-thuat}
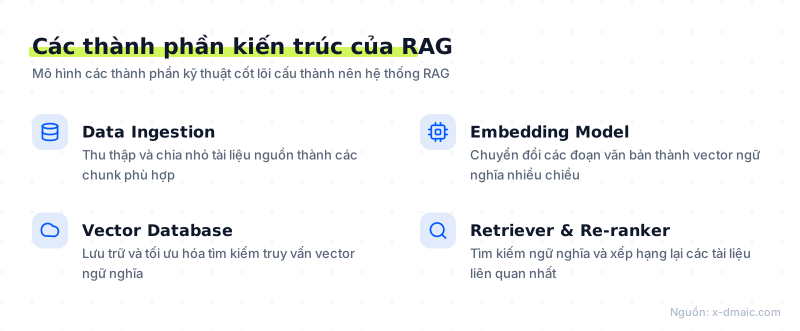
Một hệ thống RAG hoàn chỉnh thường gồm các thành phần sau:
- Data ingestion (nạp dữ liệu): Thu thập tài liệu nguồn (PDF, Word, trang web, database...) và chia nhỏ thành các đoạn (chunks) có kích thước hợp lý — thường 200–500 token/đoạn tùy use case.
- Embedding model: Chuyển mỗi đoạn văn bản thành vector số nhiều chiều, thể hiện ý nghĩa ngữ nghĩa. Các mô hình phổ biến:
text-embedding-3(OpenAI),voyage-3(Voyage AI), hoặc các mô hình mã nguồn mở nhưBGE,E5. - Vector database: Lưu trữ và tìm kiếm các vector này hiệu quả. Các lựa chọn phổ biến: Pinecone, Weaviate, Milvus, Qdrant, hoặc pgvector (extension của PostgreSQL).
- Retriever: Thành phần thực hiện tìm kiếm — có thể là tìm kiếm ngữ nghĩa thuần (dense retrieval), tìm kiếm từ khóa truyền thống (sparse/BM25), hoặc kết hợp cả hai (hybrid search).
- Re-ranker (tùy chọn): Lớp xếp hạng lại kết quả truy xuất để đảm bảo các đoạn liên quan nhất được ưu tiên trước khi đưa vào prompt.
- LLM (Generator): Mô hình ngôn ngữ nhận ngữ cảnh và câu hỏi, tổng hợp thành câu trả lời cuối cùng.
Lưu ý kỹ thuật quan trọng: chất lượng của một hệ thống RAG phụ thuộc rất nhiều vào chiến lược chia đoạn (chunking strategy). Chia đoạn quá nhỏ khiến mất ngữ cảnh, chia quá lớn khiến kết quả tìm kiếm kém chính xác và tốn token không cần thiết. Trong thực tế triển khai, việc điều chỉnh kích thước chunk và độ chồng lấp (overlap) giữa các đoạn thường mang lại cải thiện rõ rệt hơn là việc đổi sang mô hình embedding "xịn" hơn.
Lợi ích thực tế của RAG
- Giảm ảo giác (hallucination): Vì câu trả lời được neo vào dữ liệu truy xuất thực tế, mô hình ít bịa thông tin hơn so với khi chỉ dựa vào trí nhớ tham số.
- Cập nhật dữ liệu không cần huấn luyện lại mô hình: Chỉ cần cập nhật cơ sở dữ liệu tài liệu, hệ thống lập tức "biết" thông tin mới — nhanh và rẻ hơn nhiều so với fine-tuning.
- Minh bạch, có thể trích dẫn nguồn: Hệ thống RAG có thể hiển thị đoạn tài liệu gốc làm căn cứ cho câu trả lời, giúp người dùng kiểm chứng.
- Tiết kiệm chi phí so với huấn luyện lại: Fine-tuning một mô hình lớn tốn kém về hạ tầng và thời gian; RAG chỉ cần đầu tư vào pipeline truy xuất dữ liệu.
- Bảo mật dữ liệu tốt hơn: Dữ liệu nội bộ/nhạy cảm có thể giữ trong hệ thống riêng, không cần đưa vào quá trình huấn luyện mô hình.
Hạn chế và thách thức khi triển khai RAG
Không nên "thần thánh hóa" RAG — kỹ thuật này có những giới hạn thực tế cần lưu ý:
- Chất lượng phụ thuộc vào chất lượng truy xuất: Nếu retriever tìm sai đoạn tài liệu, LLM sẽ trả lời sai dù mô hình có mạnh đến đâu — hiện tượng gọi là "garbage in, garbage out".
- Độ trễ tăng thêm: Bước truy xuất dữ liệu cộng thêm thời gian phản hồi so với gọi LLM trực tiếp, cần cân nhắc khi thiết kế trải nghiệm người dùng thời gian thực.
- Chi phí vận hành vector database: Với tập dữ liệu lớn (hàng triệu đoạn văn bản), chi phí lưu trữ và truy vấn vector có thể đáng kể.
- Khó xử lý câu hỏi cần tổng hợp đa nguồn phức tạp: RAG truyền thống tối ưu cho câu hỏi có câu trả lời nằm trong 1-vài đoạn tài liệu cụ thể; với câu hỏi cần suy luận qua nhiều tài liệu (multi-hop reasoning), cần các kỹ thuật nâng cao hơn như Graph RAG hoặc Agentic RAG.
- Vẫn có thể xảy ra ảo giác: RAG giảm chứ không loại bỏ hoàn toàn hallucination — nếu tài liệu truy xuất mâu thuẫn hoặc không đầy đủ, mô hình vẫn có thể suy diễn sai.
RAG khác gì Fine-tuning?
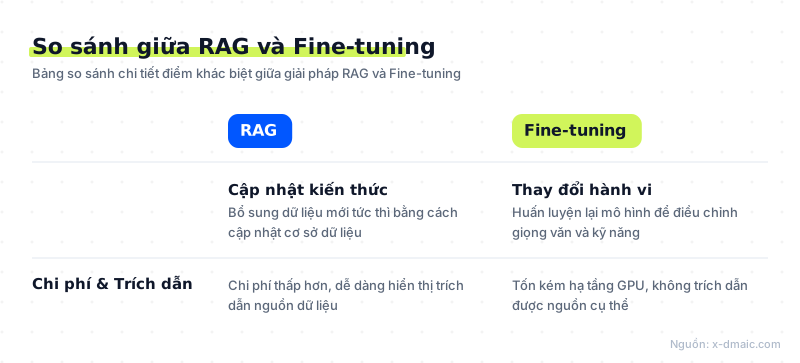
Đây là câu hỏi phổ biến nhất khi mới tìm hiểu RAG. Bảng so sánh dưới đây tóm tắt sự khác biệt cốt lõi:
| Tiêu chí | RAG | Fine-tuning |
|---|---|---|
| Mục đích chính | Bổ sung kiến thức/dữ liệu mới | Thay đổi hành vi, phong cách, kỹ năng của mô hình |
| Cập nhật dữ liệu | Nhanh, chỉ cần cập nhật tài liệu | Chậm, cần huấn luyện lại toàn bộ hoặc một phần mô hình |
| Chi phí | Thấp – trung bình | Cao, cần hạ tầng GPU và dữ liệu huấn luyện chất lượng |
| Khả năng trích dẫn nguồn | Có, dễ dàng | Không — kiến thức "ẩn" trong tham số mô hình |
| Phù hợp nhất khi | Dữ liệu thay đổi thường xuyên, cần minh bạch nguồn | Cần mô hình thay đổi cách suy luận, giọng văn, hoặc kỹ năng chuyên biệt |
Trong thực tế, hai kỹ thuật này không loại trừ nhau — nhiều hệ thống production kết hợp cả RAG (để cập nhật kiến thức) và fine-tuning nhẹ (để điều chỉnh phong cách trả lời) nhằm đạt hiệu quả tối ưu.
Ứng dụng thực tế của RAG
- Chatbot hỗ trợ khách hàng: Trả lời dựa trên tài liệu sản phẩm, FAQ, chính sách công ty cập nhật liên tục.
- Trợ lý tra cứu nội bộ doanh nghiệp: Nhân viên hỏi nhanh về quy trình, chính sách nhân sự, tài liệu kỹ thuật nội bộ.
- Công cụ nghiên cứu pháp lý/y tế: Tra cứu văn bản luật, tài liệu y khoa mới nhất — nơi độ chính xác và khả năng trích dẫn nguồn là bắt buộc.
- Trợ lý lập trình: Truy xuất tài liệu API, codebase nội bộ để đưa ra gợi ý code chính xác với ngữ cảnh dự án cụ thể.
- Công cụ tìm kiếm hội thoại (conversational search): Nền tảng cho các tính năng như Google AI Overview, Bing Copilot — kết hợp tìm kiếm web với khả năng tổng hợp câu trả lời tự nhiên.
Các bước xây dựng hệ thống RAG cơ bản
- Thu thập và làm sạch dữ liệu nguồn — loại bỏ nội dung trùng lặp, định dạng lộn xộn.
- Chia nhỏ tài liệu (chunking) — chọn kích thước đoạn phù hợp với loại nội dung (văn bản pháp lý cần chunk khác với FAQ ngắn).
- Tạo embedding và lưu vào vector database — chọn mô hình embedding phù hợp ngôn ngữ và lĩnh vực.
- Xây dựng pipeline truy xuất — thử nghiệm dense search, sparse search, hoặc hybrid search tùy đặc thù dữ liệu.
- Thiết kế prompt ghép ngữ cảnh — quy định rõ cách LLM sử dụng đoạn truy xuất được, tránh trả lời ngoài phạm vi tài liệu nếu cần độ tin cậy cao.
- Đánh giá và tinh chỉnh (evaluation): đo lường độ chính xác truy xuất (retrieval accuracy) và chất lượng câu trả lời bằng bộ câu hỏi kiểm thử thực tế, sau đó lặp lại điều chỉnh chunking, mô hình embedding, hoặc chiến lược re-rank.
Xu Hướng RAG Đáng Chú Ý (2026)
Tính đến giữa năm 2026, RAG đã tiến hóa xa hơn mô hình "truy xuất rồi sinh" (retrieve-then-generate) đơn giản ban đầu:
-
GraphRAG: Kết hợp tìm kiếm vector với các cấu trúc phân loại và bản thể học (ontology), đưa ngữ cảnh và logic quan hệ vào quá trình truy xuất, giúp trả lời tốt hơn các câu hỏi cần suy luận qua nhiều thực thể liên quan. Cách tiếp cận này đang được ứng dụng nhiều trong lĩnh vực tài chính và y tế — nơi cần khả năng lý giải và tuân thủ quy định chặt chẽ.
-
Agentic RAG: Thay vì chỉ truy xuất một lần rồi trả lời, các hệ thống agentic tự lập kế hoạch, gọi nhiều công cụ, tự đánh giá và tinh chỉnh lại truy vấn truy xuất qua nhiều bước, phù hợp với các tác vụ phức tạp cần suy luận nhiều bước.
-
Self-RAG: Mô hình tự quyết định thời điểm cần truy xuất thêm dữ liệu và tự phê bình lại câu trả lời của chính mình trước khi trả về người dùng, giúp giảm số lần truy xuất không cần thiết.
-
Hybrid Search làm baseline production: Kết hợp tìm kiếm từ khóa và tìm kiếm ngữ nghĩa đang trở thành tiêu chuẩn mặc định cho các hệ thống RAG chạy thật, vì giải quyết được điểm yếu về tên riêng, mã số, thuật ngữ chuyên ngành mà vector search thuần túy hay bỏ sót.
Điều quan trọng cần lưu ý: các kiến trúc phức tạp như GraphRAG hay Agentic RAG chỉ thực sự đáng chi phí đầu tư khi bài toán yêu cầu suy luận nhiều bước hoặc kết nối dữ liệu xuyên tài liệu; với các tác vụ tra cứu đơn giản, một pipeline RAG truyền thống kết hợp hybrid search và reranker thường đã đủ hiệu quả với chi phí thấp hơn nhiều.
Câu hỏi thường gặp (FAQ)
RAG là gì trong AI? RAG (Retrieval-Augmented Generation) là kỹ thuật kết hợp truy xuất dữ liệu từ nguồn bên ngoài với mô hình ngôn ngữ lớn, giúp AI trả lời chính xác và cập nhật hơn thay vì chỉ dựa vào kiến thức đã học sẵn. RAG có loại bỏ hoàn toàn hiện tượng ảo giác (hallucination) của AI không? Không. RAG làm giảm đáng kể hallucination nhờ câu trả lời có căn cứ trên dữ liệu thật, nhưng không loại bỏ hoàn toàn — mô hình vẫn có thể suy diễn sai nếu tài liệu truy xuất không đầy đủ hoặc mâu thuẫn. RAG có cần GPU mạnh để chạy không? Bước truy xuất (retrieval) không đòi hỏi GPU mạnh, chủ yếu cần hạ tầng vector database hiệu quả. GPU chỉ thực sự cần thiết nếu bạn tự host mô hình embedding hoặc LLM thay vì gọi qua API. Nên chọn RAG hay Fine-tuning cho doanh nghiệp? Nếu dữ liệu của bạn thay đổi thường xuyên và cần khả năng trích dẫn nguồn minh bạch, RAG là lựa chọn phù hợp hơn và triển khai nhanh hơn. Fine-tuning phù hợp hơn khi cần thay đổi phong cách hoặc kỹ năng suy luận chuyên biệt của mô hình. Vector database nào phổ biến nhất để triển khai RAG? Một số lựa chọn phổ biến gồm Pinecone, Weaviate, Milvus, Qdrant (chuyên dụng) và pgvector (extension của PostgreSQL, phù hợp cho hệ thống đã dùng sẵn Postgres).
Nguồn tham khảo
- Lewis, P. et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Meta AI Research / arXiv. https://arxiv.org/abs/2005.11401
Đọc tiếp trong chủ đề: AI cho doanh nghiệp
- Chatbot AI trên website – Làm được gì, không làm được gì
- Vector Database Là Gì?
- SO SÁNH VECTOR DATABASE — Pinecone vs Milvus vs Qdrant vs Weaviate vs pgvector
- So sánh RAG và Fine-tuning
Cần X-DMAIC hỗ trợ? Đăng ký tư vấn miễn phí hoặc nhắn Zalo 0394 877 577.