Trong bài này (15 mục)
- Hallucination là gì?
- Vì sao AI bịa thông tin?
- Các dạng AI bịa hay gặp trong bài doanh nghiệp
- Cách chặn AI bịa thông tin theo từng lớp
- Lớp 1: giới hạn nguồn, cho AI tra tài liệu doanh nghiệp
- Lớp 2: luật trong prompt, thiếu dữ kiện thì không tự điền
- Lớp 3: kiểm bằng máy những gì đối chiếu được
- Lớp 4: người duyệt đọc các câu nói về doanh nghiệp
- Bảng: dạng bịa, cách phát hiện, cách chặn
- Ghép bốn lớp thành một quy trình
- Câu hỏi thường gặp
- Có cách nào để AI không bao giờ bịa thông tin không?
- Dùng mô hình AI mới hơn, đắt hơn thì có hết bịa không?
- RAG có thay được người duyệt không?
- Khi tài liệu không có giá, bài nên viết thế nào?
Vì sao AI bịa thông tin, và chặn bằng cách nào? AI bịa thông tin (hallucination, còn gọi là ảo giác AI) là khi mô hình ngôn ngữ viết ra một câu nghe rất hợp lý nhưng sai sự thật. Nghiên cứu của OpenAI năm 2025 cho rằng nguyên nhân chính là cách huấn luyện và chấm điểm mô hình đang thưởng cho việc đoán hơn là nói "không biết". Khi viết bài cho doanh nghiệp, cách chặn hiệu quả thường gồm bốn lớp: giới hạn nguồn, đặt luật trong prompt, kiểm bằng máy những gì đối chiếu được, và người duyệt đọc các câu nói về doanh nghiệp.
Bài này giúp anh chị hiểu vì sao AI bịa, nhận ra những dạng bịa hay gặp trong bài viết của doanh nghiệp, và dựng quy trình chặn trước khi bài lên website. Bài nằm trong cụm viết bài SEO bằng AI, tập trung vào một rủi ro cụ thể: bài đăng dưới tên doanh nghiệp nói sai về chính doanh nghiệp đó.
Hallucination là gì?
Hallucination là khi AI đưa ra thông tin sai nhưng trình bày tự tin như thông tin đúng. Nhóm tác giả của bài nghiên cứu (OpenAI và Georgia Tech) mô tả đó là những "điều sai nghe có vẻ hợp lý" (Kalai và cộng sự, arXiv 2509.04664, 2025).
Điểm khó là câu bịa không trông giống câu bịa: đúng giọng văn, đúng thuật ngữ, đúng định dạng số. Một câu như "Công ty có hơn 12 năm kinh nghiệm và bảo hành 5 năm cho mọi hạng mục" (giả định) đọc lướt rất trôi. Người không nắm thông tin doanh nghiệp khó thấy nó sai.
Với bài blog chung chung, một chi tiết sai có thể chỉ làm bài kém tin cậy. Với bài nói về dịch vụ, giá, chính sách của doanh nghiệp, một chi tiết sai là một lời hứa sai với khách hàng thật.
Vì sao AI bịa thông tin?
Tháng 09/2025, OpenAI công bố nghiên cứu "Why Language Models Hallucinate" (OpenAI, 2025). Lập luận chính có hai phần.
Phần 1: ngay từ khâu học, có những thứ mô hình buộc phải đoán. Mô hình ngôn ngữ học bằng cách đoán chữ tiếp theo trên lượng văn bản rất lớn. Quy luật lặp lại nhiều lần như chính tả, ngữ pháp thì học tốt. Nhưng dữ kiện lẻ, không theo quy luật nào, như ngày sinh của một người cụ thể, nếu hiếm khi xuất hiện trong dữ liệu thì mô hình không có cách suy ra, và câu trả lời về bản chất là một phép đoán. Bài nghiên cứu lấy ví dụ: hỏi ngày sinh của chính một tác giả, kèm dặn "nếu biết thì chỉ trả lời theo dạng ngày-tháng", một mô hình ngôn ngữ mã nguồn mở hiện đại vẫn đưa ra ba ngày khác nhau qua ba lần hỏi, và không ngày nào đúng (arXiv 2509.04664).
Phần 2: cách chấm điểm khuyến khích đoán thay vì thừa nhận không biết. Phần lớn các bộ đánh giá mô hình chấm theo kiểu đúng được 1 điểm, sai hoặc trả lời "không biết" đều 0 điểm. Theo cách chấm này, đoán bừa không bao giờ thiệt hơn bỏ trống. Nhóm tác giả so sánh với học sinh làm bài trắc nghiệm: không chắc thì cứ khoanh, vì để trống thì mất điểm. Mô hình được tối ưu để thành "thí sinh giỏi làm bài thi", nên quen với việc đoán (arXiv 2509.04664).
Bài nghiên cứu đề xuất sửa cách chấm: phạt câu sai tự tin nặng hơn câu "không biết", và nêu rõ ngưỡng tự tin, ví dụ chỉ trả lời khi đủ chắc, sai sẽ bị trừ điểm. Với người dùng, bài học thực tế là: nếu không được dặn và không có nguồn, mô hình có xu hướng tự điền chỗ trống bằng một câu trả lời nghe hợp lý.
Các dạng AI bịa hay gặp trong bài doanh nghiệp
Trong bài doanh nghiệp, chỗ AI dễ tự điền nhất thường là những dữ kiện riêng của từng doanh nghiệp. Đây đúng là loại "dữ kiện lẻ" mà mô hình không thể biết nếu không được cung cấp. Các câu trong ngoặc kép dưới đây là ví dụ giả định về câu cần bắt, không phải số liệu thật:
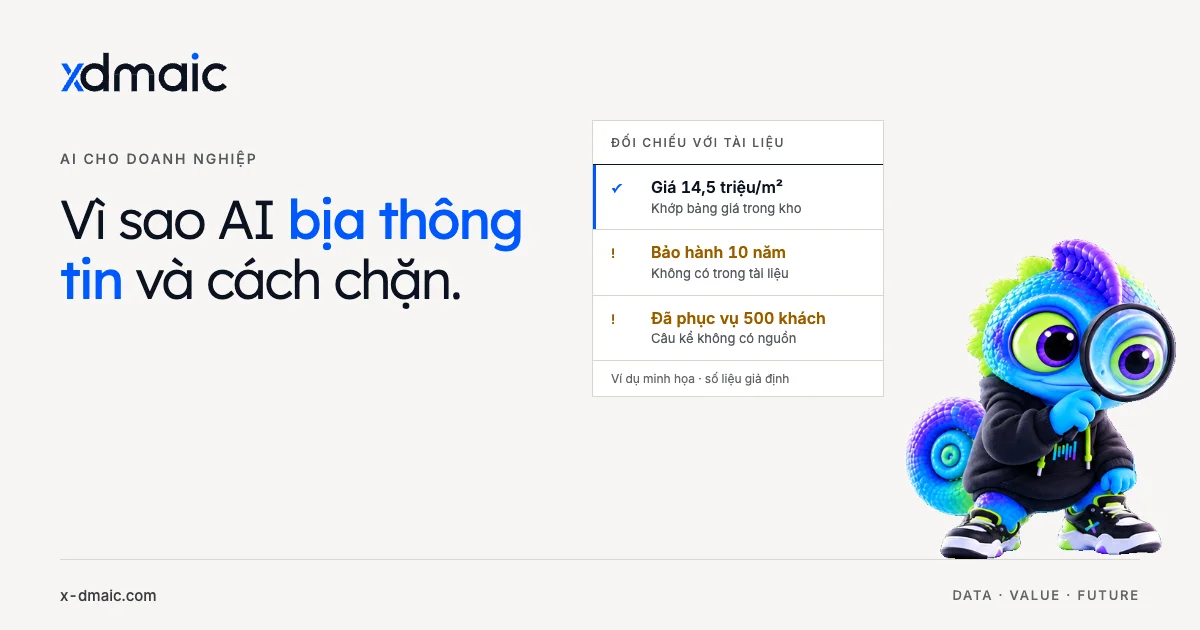
- Giá và chi phí: "Gói thiết kế từ 15 triệu đồng" trong khi doanh nghiệp chưa từng công bố giá.
- Bảo hành, cam kết, thời hạn: "Bảo hành 10 năm", "bàn giao trong 7 ngày".
- Số năm kinh nghiệm, số khách, số dự án: "Hơn 500 khách hàng tin dùng".
- Chứng nhận, giải thưởng, đối tác: tên chứng chỉ hoặc đối tác nghe rất thật.
- Trích dẫn và nguồn không tồn tại: dẫn một nghiên cứu, một điều luật, một đường link không có thật hoặc không nói điều được trích.
- Trải nghiệm khách hàng: "Anh Minh, giám đốc một công ty logistics, chia sẻ…", một câu chuyện không ai kể.
- Thông tin liên hệ: số điện thoại, địa chỉ chi nhánh sai một vài ký tự.
Điểm chung: đều là câu khẳng định về doanh nghiệp, đều kiểm được nếu có tài liệu gốc.
Cách chặn AI bịa thông tin theo từng lớp
Không có một biện pháp đơn lẻ nào chặn được mọi câu bịa. Cách làm thực tế là xếp nhiều lớp, lớp sau bắt những gì lớp trước để lọt.
Lớp 1: giới hạn nguồn, cho AI tra tài liệu doanh nghiệp
Thay vì để AI viết từ "trí nhớ" của mô hình, anh chị đưa tài liệu thật: trang dịch vụ, hồ sơ năng lực, bảng giá, chính sách bảo hành. Khi soạn, hệ thống tìm đoạn liên quan và đưa cho AI dựa vào. Kỹ thuật này gọi là RAG, chúng tôi giải thích kỹ trong bài RAG là gì.
Cần nói rõ: RAG giảm bịa đặt, nhưng không loại bỏ hoàn toàn. AI vẫn có thể đọc sai tài liệu, ghép hai dữ kiện không liên quan, hoặc tự thêm chi tiết khi tài liệu không nói tới. Bài nghiên cứu của OpenAI cũng có một mục nói tìm kiếm và RAG "không phải thuốc chữa bách bệnh": chúng giúp giảm hallucination, nhưng khi cách chấm điểm vẫn thưởng cho việc đoán, mô hình vẫn có lý do để đoán ở chỗ tra không ra (arXiv 2509.04664). Vì vậy vẫn cần các lớp phía sau.
Lớp 2: luật trong prompt, thiếu dữ kiện thì không tự điền
Lớp này áp dụng trực tiếp tinh thần của bài nghiên cứu: cho mô hình "được phép không biết". Một số luật nên có trong prompt:
- Chỉ nêu giá, thời hạn, chính sách, số liệu về doanh nghiệp khi có trong tài liệu được cung cấp.
- Thiếu dữ kiện thì không đoán. Thay bằng câu mời khách liên hệ, ví dụ: "Chi phí phụ thuộc phạm vi dự án, anh chị liên hệ để nhận báo giá."
- Không tự tạo lời kể của khách hàng, tên người, tên công ty.
- Không dẫn nguồn ngoài nếu không có đường link được cung cấp.
Luật trong prompt giảm số chỗ tự điền, nhưng mô hình không tuân thủ tuyệt đối. Đây là một lớp lọc, không phải lời cam kết.
Lớp 3: kiểm bằng máy những gì đối chiếu được
Có những lỗi máy kiểm tốt hơn người đọc mỏi mắt:
- Số điện thoại, email, địa chỉ: so với danh sách chính thức của doanh nghiệp.
- Số tiền, thời hạn bảo hành: tìm mọi con số đi kèm "đồng", "triệu", "năm", "tháng", số nào không có trong kho thì gắn cờ.
- Từ cấm: danh sách từ doanh nghiệp không muốn dùng, như "rẻ nhất", "số 1", hay tên đối thủ.
- Phép tính: tổng, phần trăm trong bài có cộng đúng không.
- Đường link: link có mở được không, có trỏ đúng trang không.
Máy không hiểu được câu kể chuyện hay câu khẳng định chung chung. Phần đó để lại cho lớp cuối.
Lớp 4: người duyệt đọc các câu nói về doanh nghiệp
Người duyệt nên dồn chú ý vào các câu khẳng định về doanh nghiệp: dịch vụ gì, cho ai, giá bao nhiêu, cam kết gì, đã làm cho ai. Phần kiến thức chung ít rủi ro hơn, đọc nhanh được. Người duyệt nên là người nắm thông tin thật, như trưởng phòng kinh doanh hoặc chủ doanh nghiệp.
Nếu hệ thống đánh dấu sẵn các câu này, việc duyệt nhanh hơn đọc trơn. Khi từ chối, ghi lý do cụ thể để lần soạn sau không lặp lỗi.
Bảng: dạng bịa, cách phát hiện, cách chặn
| Dạng bịa | Cách phát hiện | Cách chặn |
|---|---|---|
| Giá, chi phí | Máy tìm số tiền, đối chiếu bảng giá trong kho | Luật prompt: không có giá thì mời liên hệ báo giá |
| Bảo hành, thời hạn | Máy tìm cụm "bảo hành", số năm, số ngày rồi đối chiếu | Chỉ nêu khi có trong chính sách; người duyệt xác nhận |
| Số năm kinh nghiệm, số khách, số dự án | Gắn cờ mọi câu có số liệu về doanh nghiệp | Nạp hồ sơ năng lực vào kho; người duyệt đối chiếu |
| Chứng nhận, đối tác, giải thưởng | Người duyệt đọc các câu có tên riêng | Luật prompt: không nêu tên tổ chức không có trong tài liệu |
| Trích dẫn, nguồn không tồn tại | Máy kiểm link; người duyệt mở nguồn đọc lại | Chỉ dẫn nguồn có đường link được cung cấp |
| Trải nghiệm, lời kể khách hàng | Gắn cờ câu có tên người, câu kể chuyện | Luật prompt: không tự tạo lời kể; chỉ dùng phản hồi thật đã được đồng ý |
| Số điện thoại, địa chỉ | Máy so với danh sách liên hệ chính thức | Chèn thông tin liên hệ từ một nguồn cố định, không để AI gõ lại |
Ghép bốn lớp thành một quy trình
Thứ tự nên cố định: AI soạn nháp từ kho tài liệu, máy kiểm những gì đối chiếu được, người duyệt đọc phần còn lại, rồi mới đăng. Bỏ bước duyệt để đăng nhanh thì các câu máy không kiểm được sẽ lên thẳng website.
Đó cũng là cách chúng tôi làm quy trình có người duyệt trong XD DashWP: AI chỉ soạn từ kho tài liệu anh chị nạp vào, app chặn từ cấm, số điện thoại lạ, phép tính sai, nhắc số tiền và thời hạn bảo hành không có trong kho, và bài chỉ lên WordPress khi người duyệt đồng ý. App hiện chưa đối chiếu được mọi câu với kho, nên người duyệt vẫn là lớp cuối không thay được.
Trước khi đăng, anh chị có thể dùng thêm checklist kiểm tra bài AI trước khi đăng để rà lần cuối. Nếu còn băn khoăn về phía Google, bài AI viết bài có bị Google phạt không đi sâu vào chính sách liên quan.
Câu hỏi thường gặp
Có cách nào để AI không bao giờ bịa thông tin không?
Hiện chưa có cách loại bỏ hoàn toàn. Giới hạn nguồn, luật prompt và kiểm bằng máy giảm được nhiều, nhưng câu nói về doanh nghiệp vẫn nên có người nắm thông tin đọc lại.
Dùng mô hình AI mới hơn, đắt hơn thì có hết bịa không?
Mô hình mới có thể cải thiện, nhưng theo lập luận của nghiên cứu OpenAI, nguyên nhân nằm ở cả cách huấn luyện và cách chấm điểm, không chỉ ở độ lớn mô hình. Với dữ kiện riêng của doanh nghiệp mà mô hình chưa từng thấy, mô hình nào cũng cần được cung cấp tài liệu.
RAG có thay được người duyệt không?
Không. RAG giúp AI có nguồn đúng để dựa vào, nhưng AI vẫn có thể đọc sai hoặc thêm chi tiết ngoài tài liệu. Người duyệt là lớp bắt những lỗi đó.
Khi tài liệu không có giá, bài nên viết thế nào?
Nói rõ chi phí phụ thuộc yếu tố nào, rồi mời khách liên hệ để nhận báo giá. Cách này trung thực hơn một con số tự đặt, và thường vẫn giúp khách ra quyết định bước tiếp theo.